
编程 agent 是模型,加上你在它周围搭建的一切。Harness 工程把这套脚手架当作真正的工程产物,并且每当 agent 出错时就把它拧紧一格。
大致来说:任何时候你发现 agent 犯了一个错误,你就花时间设计一个解法,让 agent 永远不会再犯同一个错误。
过去两年我们一直在争论模型:哪个最聪明、哪个写的 React 最干净、哪个幻觉更少。这个讨论本身没问题,但它只看到了系统的一半。模型只是运行中的 agent 的一个输入,其余部分都是 harness:围绕模型包装的提示词、工具、上下文策略、hooks、沙箱、subagent、反馈循环和恢复路径——正是这些东西让模型能真正把一件事做完。
一个中等的模型配上出色的 harness,胜过一个出色的模型配上糟糕的 harness。 我在自己的工作中一次次看到这一点被验证。而且越来越明显的是,真正有趣的工程不在于选模型,而在于设计它周围的脚手架。
这门手艺现在有了名字。Viv Trivedy 创造了 harness engineering 这个说法,他的《Anatomy of an Agent Harness》是推导「harness 到底是什么、为什么每一块都存在」最干净的一篇。⟦Dex Horthy 一直在跟踪这个模式的成形。HumanLayer 把大多数 agent 失败归结为「skill issue」,即问题出在配置上,而不是模型权重上。Anthropic 的工程团队发表了我认为目前关于「如何为长时任务设计 harness」最好的公开拆解。而 Birgitta Böckeler 从用户视角给出了一个不错的概览。
这篇文章是我把这些线索串起来的尝试。
什么是 harness?
Viv 的一句话概括已经做完了大部分工作:
Agent = Model + Harness。如果你不是模型,那你就是 harness。
Harness 就是一切不属于模型本身的代码、配置和执行逻辑。一个裸模型不是 agent。只有当 harness 赋予它状态、工具执行、反馈循环和可强制执行的约束之后,它才成为 agent。
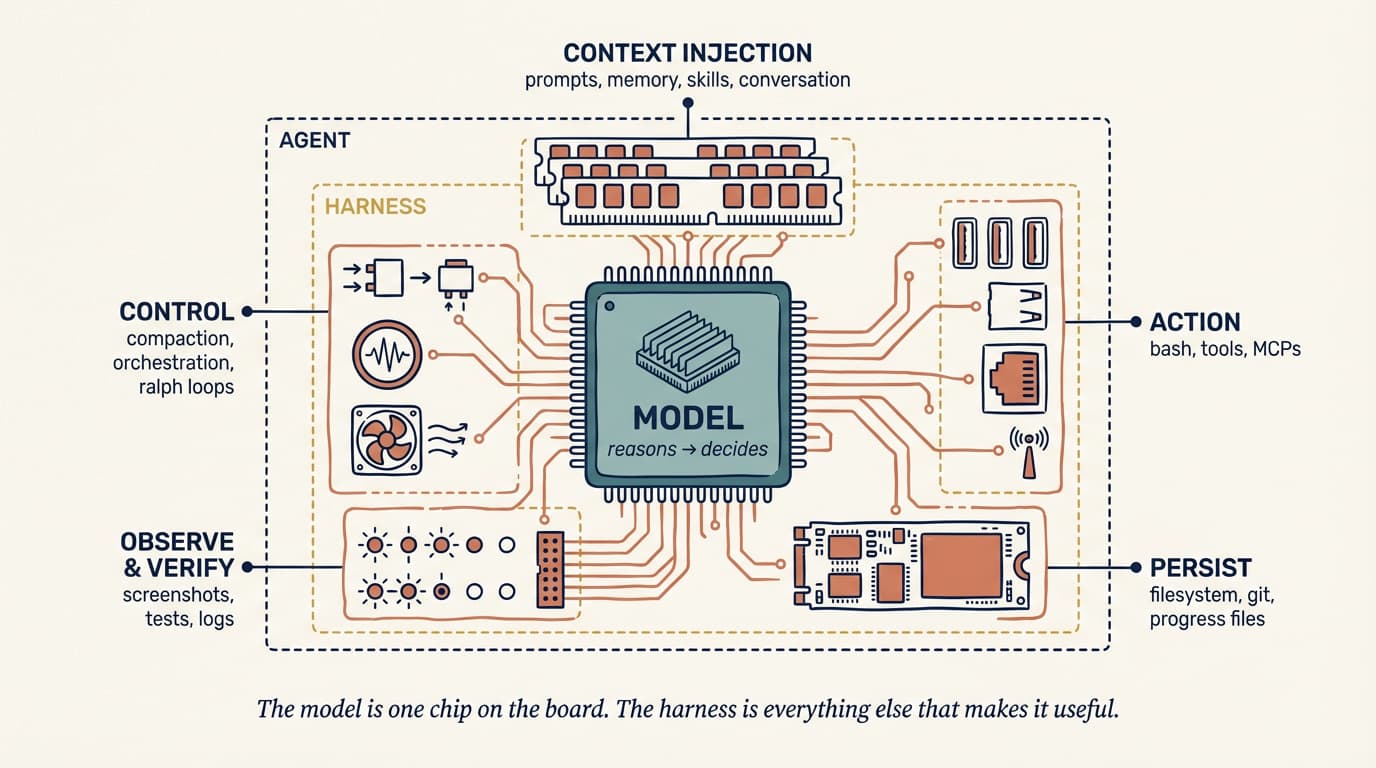
具体来说,一个 harness 包括:
- 系统提示词、
CLAUDE.md、AGENTS.md、skill 文件和 subagent 提示词 - 工具、skills、MCP server,以及它们的描述
- 打包好的基础设施(文件系统、沙箱、浏览器)
- 编排逻辑(subagent 派生、任务交接、模型路由)
- 用于确定性执行的 hooks 和中间件(压缩、续跑、lint 检查)
- 可观测性(日志、trace、成本与延迟计量)
Simon Willison 把循环那一部分压缩到了本质:agent 是一个*「在循环中运行工具以达成某个目标」*的系统。功夫在于工具的设计,也在于循环的设计。
如果这听起来涉及面很广——确实很广。而这是你要面对的界面,不是模型提供商的。Claude Code、Cursor、Codex、Aider、Cline 全都是 harness。底下的模型有时是同一个,但你实际体验到的行为主要由 harness 决定。
coding agent = AI model(s) + harness
这个由 Viv 提出、被 HumanLayer 呼应的等式,才是工作真正所在的地方。关于等式左边的争论很响,但真正的杠杆大多在右边。
「skill issue」这个重新框定
我观察到工程师们总会掉进一个模式:agent 干了件蠢事,工程师怪模型,然后把责任归档到「等下一个版本吧」。
Harness 工程的心态拒绝这种默认反应。失败通常是有迹可循的。agent 不知道某条约定,你就把它写进 AGENTS.md;agent 执行了破坏性命令,你就加一个 hook 拦住它;agent 在一个 40 步的任务里迷路了,你就把它拆成 planner 和 executor;agent 老是把坏掉的代码「做完」,你就在循环里接一个类型检查的反压信号。
HumanLayer 的说法是:「这不是模型问题,而是配置问题。」 认真对待这句话,就是 harness 工程。
Viv 的总结和 HumanLayer 的文章里都出现了一个很扎眼的数据点。在 Terminal Bench 2.0 上,跑在 Claude Code 里的 Claude Opus 4.6,得分远低于同一个模型跑在自定义 harness 里的成绩。Viv 的团队只改 harness,就把一个编程 agent 从 Top 30 提到了 Top 5。模型在 post-training 阶段会与它所针对训练的 harness 耦合。把它挪到另一个 harness 里——配上更适合你代码库的工具、更紧的提示词、更锋利的反压——就能释放原 harness 白白丢掉的能力。
这与「等 GPT-6 出来就好了」的叙事正好相反。今天的模型能做到的事,与你实际看到它们做到的事之间的差距,很大程度上就是 harness 的差距。
棘轮:每个错误都变成一条规则
Harness 工程里最重要的习惯,是把 agent 的错误当作永久信号。不是拿来一笑而过的一次性段子,也不是「这次跑得不好」重试一下就算了。是信号。
如果 agent 提了一个把测试注释掉的 PR,而我不小心合并了,那就是一个输入。下一版 AGENTS.md 会写上「永远不要注释掉测试;要么删掉,要么修好」。下一版 pre-commit hook 会在 diff 里 grep .skip( 和 xit(。下一版 reviewer subagent 会把被注释掉的测试标为阻断项。
只有当你见过真实的失败,你才加约束。只有当有能力的模型让它变得多余,你才移除约束。一个好的 AGENTS.md 里的每一行,都应该能追溯回某件具体出过错的事。
这也是为什么 harness 工程是一门手艺,而不是一个框架。适合你代码库的 harness 由你的失败史塑造。它没法下载。
从行为反推设计
实际设计 harness 时,我觉得 Viv 最有用的框架是从你想要的行为出发,反推出实现它的 harness 部件。他的模式是:我们想要(或想修复)的行为 → 帮助模型达成它的 harness 设计。
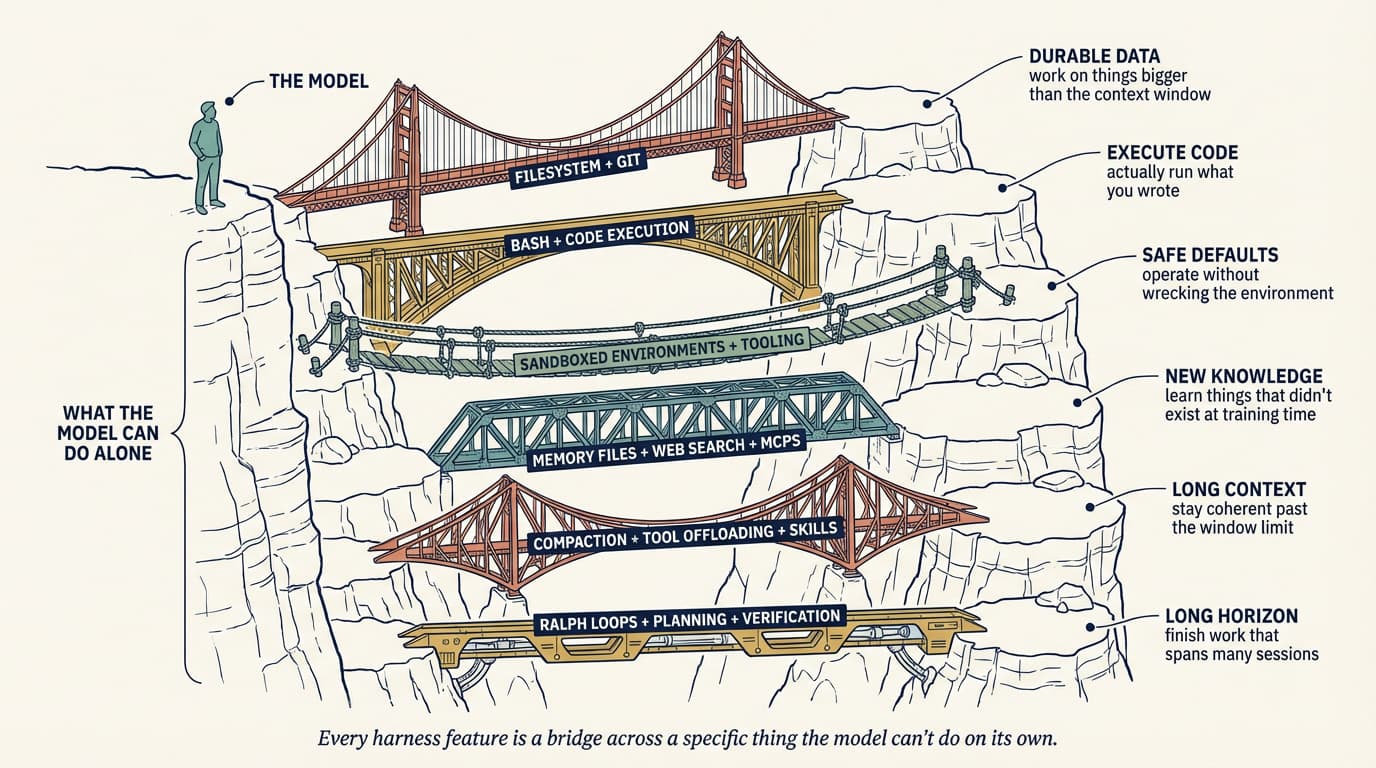
这样推导的好处是,每个 harness 组件都有明确职责。如果你说不出某个组件是为了交付哪种行为而存在,那它大概就不该存在。
下面按 Viv 大致相同的顺序走一遍,附上我觉得值得照搬的具体模式。
文件系统与 Git:持久状态
文件系统是最基础的元语,也常因为「太无聊」而被低估。模型只能直接操作放进上下文里的东西。没有文件系统,你就是在往聊天窗口里复制粘贴,那不成其为工作流。
一旦有了文件系统,agent 就有了读数据、代码和文档的工作区;有了一个把中间产物卸下来、而不是全塞进上下文的去处;也有了多个 agent 和人类可以借共享文件协作的界面。在它之上加 Git,你就白白得到了版本管理,agent 可以跟踪进度、回滚错误、开出实验分支。
大多数其他 harness 元语最终都会指向文件系统去取点什么。
Bash 与代码执行:通用工具
今天的主 agent 循环是一个 ReAct 循环:模型推理,通过工具调用采取行动,观察结果,然后重复。但 harness 只能执行它有逻辑支持的工具。你可以尝试为每一种可能的动作预建工具,也可以把 bash 交给 agent,让它临时构建自己需要的工具。
Willison 的看法是,agent 本来就擅长 shell 命令;大多数任务都能收敛到少数几次精心挑选的 CLI 调用上。Harness 仍然会提供聚焦的工具,但 bash 加代码执行已经成为自主解决问题的默认通用策略。这就像教一个人用某一件厨房小工具,和把整个厨房交给他之间的区别。
沙箱与默认工具链
Bash 只有在安全的地方执行才有用。在你的笔记本上跑 agent 生成的代码风险很大,而且单一本地环境没法扩展到很多并行 agent。
沙箱给 agent 一个隔离的运行环境。harness 不在本地执行,而是连接到一个沙箱去运行代码、检查文件、安装依赖、验证工作。你可以对命令做白名单、强制网络隔离、按需起新环境、任务结束后销毁。
一个好的沙箱自带好的默认配置:预装的语言运行时和包、Git 与测试 CLI、用于网页交互的无头浏览器。浏览器、日志、截图和测试运行器,正是让 agent 能观察自己的工作、闭合自我验证循环的东西。
模型不会去配置它的运行环境。决定 agent 在哪里运行、有什么可用、如何验证输出,全是 harness 层面的决策。
记忆与搜索:持续学习
除了权重和当前上下文里的内容,模型没有别的知识。在无法改动权重的前提下,添加知识的唯一方式就是上下文注入。
这里的元语仍然是文件系统。Harness 支持 AGENTS.md 这类记忆文件标准,在每次启动时注入。agent 编辑这个文件时,harness 会重新加载它,于是一个会话的知识会延续到下一个会话。这是一种粗糙但有效的持续学习形式。
对于训练时还不存在的知识(新库版本、当前文档、今天的数据),网络搜索和 Context7 这类 MCP 工具可以跨越知识截止点。这些是值得内建进 harness、而不是留给用户自己搞的元语。
对抗上下文腐化
上下文腐化(context rot)指的是:随着上下文窗口被填满,模型在推理和完成任务上的表现会变差。上下文是稀缺资源,而 harness 在很大程度上就是做好上下文工程的投递机制。
有三种技术反复出现:
压缩(Compaction)。 窗口快满时,总得让步。对生产级 harness 来说,让 API 直接报错不是一个选项,所以 harness 会智能地摘要并卸载较旧的上下文,让 agent 能继续工作。
工具调用卸载(Tool-call offloading)。 巨大的工具输出(比如 2000 行的日志文件)会塞满上下文,却不增加多少信号。harness 会保留超过阈值后的头尾 token,把完整输出卸到文件系统,agent 需要时再去读。
带渐进披露的 skills(Skills with progressive disclosure)。 启动时把所有工具和 MCP 都加载进上下文,会让 agent 还没动手就先掉性能。skills 让 harness 只在任务真正需要时才揭示相应指令和工具。
Anthropic 的 harness 文章为超长任务又补了一种技术:完整的上下文重置(full context resets)——harness 把会话拆掉,再从一个紧凑的交接文件重建。他们明确说,对长任务而言仅靠压缩是不够的;有时你需要带着一份结构化简报重新开始。这更接近人类给新工程师做 onboarding 的方式,而不是我们通常理解的「记忆」。
长时程执行:Ralph 循环、规划与验证
自主的长时程工作既是圣杯,也是最难做对的事。今天的模型受困于过早停止、复杂问题拆解不佳,以及工作跨越多个上下文窗口后失去连贯性。Harness 必须围绕这一切来设计。
我之前在自我改进的 agent和2026 趋势文里写过 Ralph Loop 这类自主编程循环,但放在这个框架里值得再说一遍:一个 hook 拦截模型想要退出的尝试,把原始提示词重新注入一个全新的上下文窗口,逼迫 agent 朝着完成目标继续做下去。每一轮迭代都从干净状态开始,但通过文件系统读取上一轮留下的状态。这是个简单得令人意外的技巧,却能把单会话 agent 变成多会话 agent——而且它属于那种你永远无法从「换个更聪明的模型」推导出来的元语。
**规划(Planning)**指模型把一个目标拆解成一系列步骤,通常落在磁盘上的一份计划文件里。harness 通过提示词和关于如何使用计划文件的提醒来支持这一点。每一步之后,agent 通过自我验证检查自己的工作:hooks 跑一套预定义的测试,把失败和错误文本循环回给模型;或者模型按明确的标准审查自己的输出。
Planner / generator / evaluator 拆分。 Anthropic 的长时 harness 工作明确指出,把生成与评估拆成不同的 agent,